Apify
网页抓取与自动化平台,把爬虫封装成可复用的云服务,内置代理轮换与反封锁。适合持续采集数据的团队,按计算量计费。
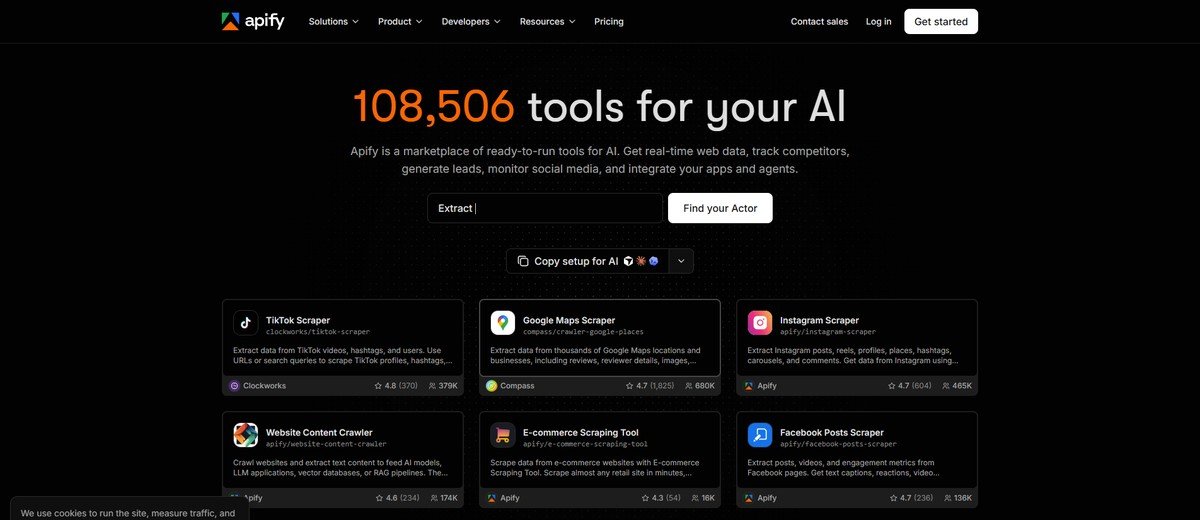
Apify 是网页抓取与自动化平台,把爬虫封装成可复用的「Actor」跑在云端,内置代理轮换与反封锁处理,也能做定时任务与流程自动化。它适合「需要持续采集数据」的团队——自己维护爬虫要处理 IP 封禁、页面改版、验证码,这些它替你扛;按计算量计费,量大要算清楚成本。
能解决什么
- 现成采集器:电商价格、社媒帖子、搜索排名、招聘信息等常见目标开箱即用。
- 云端运行:不占本地资源,支持定时任务与大规模并发。
- 自定义开发:用自己的代码写 Actor,平台负责调度、代理与存储。
- 数据输出:导出 CSV/JSON,或直接写入 Google Sheets、数据库、Webhook。
- 代理与反封锁:平台侧提供代理池与指纹管理,减少被封。
适合谁
需要定期拿竞品价格、内容素材、搜索结果,但没有专职爬虫工程师的团队;做数据驱动选品与内容选题的运营。按用量计费,小项目成本很低。
不适合谁:需要长期稳定、超大规模采集的企业。量大之后单价与平台限制会成为瓶颈,自建更划算。
使用提醒
三点:一是市场里的 Actor 由第三方开发者维护,质量参差,目标站改版后可能直接失效,选之前看更新日期与成功率,别只看下载量;二是采集的合法性取决于目标与用途——公开数据、遵守 robots 与用户协议是一回事,抓登录后内容、批量获取个人信息是另一回事,涉及后者要评估当地法规;三是按「计算单元 + 代理流量」计费,跑大站点的深度采集很容易超预算,先小样本试跑再放大。
 打开官网
快速了解
同类站点
「网络与安全」分类下还有 19 个站点,可以横向对比。 查看全部