ScraperAPI
网页抓取 API 服务,把代理轮换、JS 渲染与反封锁封装成一个接口。适合不想自建爬虫的技术团队,按请求数计费。
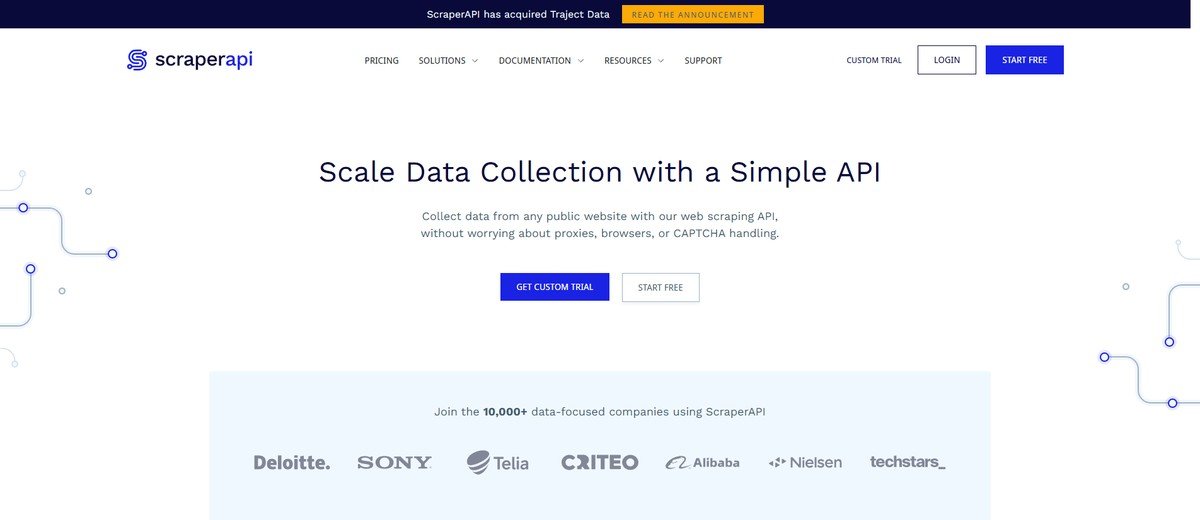
ScraperAPI 是网页抓取 API 服务,把代理轮换、JS 渲染、验证码处理、反封锁都封装在一个 HTTP 接口后面——发个 URL 过去,它返回渲染后的 HTML。它的价值是「省掉自建爬虫」——自己写要维护代理池、处理浏览器渲染、跟进反爬策略变化,这些它替你扛;按请求数计费,量大了要算账。
ScraperAPI 能解决什么问题?
ScraperAPI 的能力集中在单接口取页与JS 渲染,具体包括:
- 单接口取页:传 URL 返回 HTML,自动处理代理与重试。
- JS 渲染:可选开启浏览器渲染,抓动态加载的内容。
- 地理定位:指定国家出口,看不同地区的价格与内容。
- 结构化数据:部分目标(搜索、电商)提供解析后的 JSON。
- 并发与配额:按套餐给并发数,适合批量任务。
ScraperAPI 适合谁用?
要快速验证一个采集想法、不想先搭代理池的开发者;做价格监控与内容聚合的小团队。接入成本低到几乎只有一行代码。
不适合谁:超大规模、长期运行的采集。请求量一大,按次计费的单价比自建代理贵得多,且并发受套餐限制。
使用 ScraperAPI 要注意什么?
计费要注意「信用点」机制:普通页面算 1 个点,开 JS 渲染、用高级代理、遇到验证码重试,都可能按倍数扣。很多人的账单超预期,就是因为默认开了渲染。建议先用最小配置试跑,看清每类目标的实际消耗再放大。
另外它只是「取页工具」,解析与存储要自己写。目标站改版后,你的解析规则会失效,这部分维护成本不会因为用了 API 就消失。
 打开官网
快速了解
同类站点
「网络与安全」分类下还有 19 个站点,可以横向对比。 查看全部